

前提条件
作業を始める前に、以下の環境を準備してください。-
SambaCloud アカウントと API キー。キーは
SAMBANOVA_API_KEYとしてエクスポートしておきます。 - Node.js 22 以降のインストール済み環境
Node.js のインストール
Node.js 22 以降がインストールされていない場合は、nodejs.org からインストーラーをダウンロードするか、nvm などのバージョンマネージャーを使用してください。 インストールを確認します。セットアップ
1. Qwen Code CLI のインストール
npm を使用して Qwen Code をグローバルにインストールします。
2. SambaNova 連携の設定
オプション A: 対話形式での設定 SambaNova は組み込みプロバイダーではないため、カスタム経由で選択します。/auth を実行して Custom Provider を選択し、SambaNova の認証情報を入力します。これらはターミナルのプロンプトでありシェル変数を展開しないため、変数名ではなくキーそのものを入力してください。
qwen を起動する前にエクスポートしてください。前のステップですでに起動している場合は、いったん終了して同じシェルから qwen を再実行してください。そうしないと、実行中のプロセスは新しい値を認識しません。
対話 UI を使わない単発プロンプトの実行
-p を指定すると、1 つのプロンプトを実行して終了します。スクリプトや CI ジョブに適した実行方法です。
プロンプト例の日本語訳
プロンプト例の日本語訳
このリポジトリのアーキテクチャを要約してください。
--output-format には json と stream-json も指定できます。非対話モードの実行でも同じ 3 つの環境変数を使用します。フォールバックできる入力プロンプトがないため、ここでは環境変数が唯一の認証手段です。
OPENAI_MODEL には、SambaCloud モデル にある任意のモデル ID を指定できます。Qwen Code は、ツール呼び出しを通じてファイルの読み取り・編集やコマンド実行を行うエージェント型のコーディングツールであるため、選択するモデルは Function calling に対応している必要があります。DeepSeek-V3.1 は対応しており、コンテキストウィンドウは 128k トークンです。これが、Qwen が一度に考慮できるコードベースの量の上限になります。大規模なリポジトリでは、ツリー全体について尋ねるのではなく、@app.py のように @ でプロンプトの対象を特定のファイルに絞ってください。
ワークフローの例
このセクションでは、Qwen Code CLI を実際の GitHub プロジェクトでどのように活用できるかを紹介します。よく構成されたいくつかのプロンプトを与えるだけで、Qwen はコードベースの把握、パフォーマンスの最適化、機能の拡張、ドキュメント作成の効率化を支援します。 以下の例を通じて、次の方法を学べます。- コードベース全体のアーキテクチャを分析する
- メモリ効率を高めるために関数を最適化する
- 新しいコンポーネントを組み込んで機能を拡張する
- バージョン管理された更新を GitHub に直接プッシュする
- すべての更新を明確で構造化された changelog に記録する
1. コードベースの探索と理解
サンプルリポジトリをクローンし、プロジェクトディレクトリに移動します。プロンプト例の日本語訳
プロンプト例の日本語訳
このコードベースのアーキテクチャを説明してください。
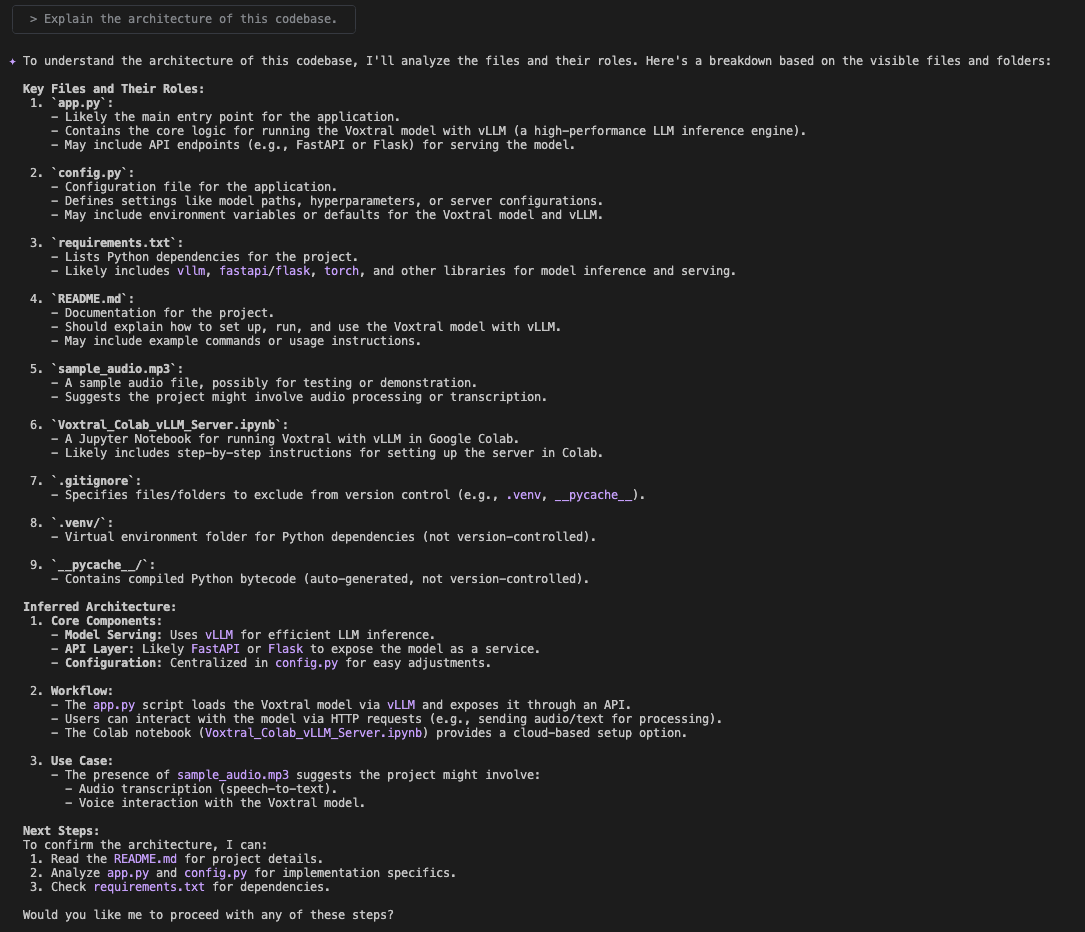
app.py、config.py、requirements.txt などのファイルを自動的にスキャンし、次のステップの提案とともに、アーキテクチャの概要を生成します。
2. コードの最適化とテスト
改善の余地をいくつか特定したら、最も効果の大きい変更のひとつであるtranscribe_audio 関数のメモリ使用量の最適化に取り組みます。このファイルを対象にするには、次のプロンプトを使用します。
プロンプト例の日本語訳
プロンプト例の日本語訳
@app.py の transcribe_audio のコードを最適化してください。
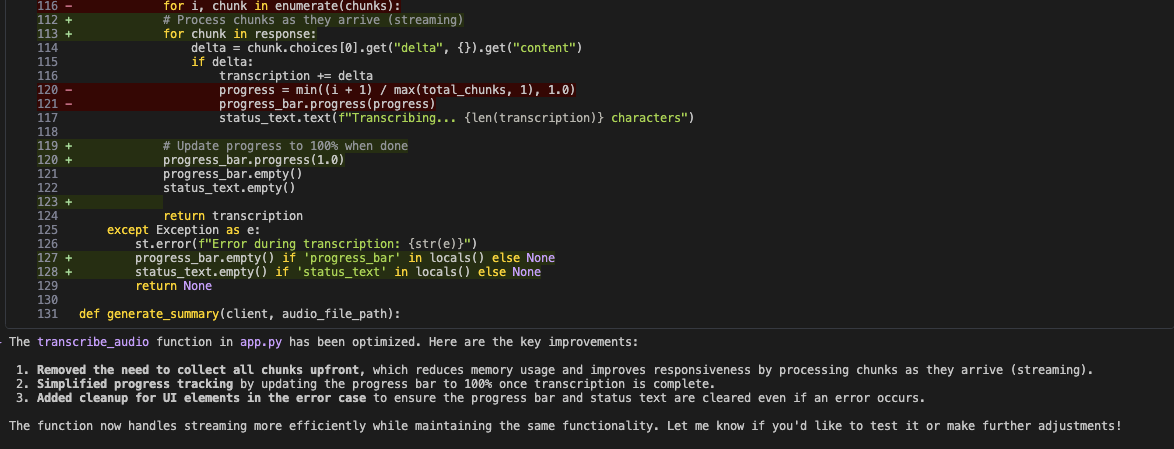
- すべてのチャンクを事前に収集するのではなく、文字起こし結果を直接ストリーミングすることで、メモリ使用量を削減し応答性を向上
- 文字起こしの完了時にのみ進捗バーを 100% に更新するよう、進捗管理を簡素化
- エラー発生時にも UI 要素をクリーンアップし、進捗バーとステータステキストが適切にクリアされることを保証
3. 新機能の追加
アプリケーションの機能を広げるため、Qwen CLI に YouTube 動画のサポートを追加するよう依頼します。プロンプト例の日本語訳
プロンプト例の日本語訳
現在のサンプルを、YouTube 動画に対応するよう拡張してください。ユーザーが YouTube の URL を指定したら、動画から音声を抽出して Voxtral モデルに渡して処理します。パイプラインとコンポーネントのそれ以外の部分は変更しないでください。
app.py、config.py、requirements.txt を分析し、yt-dlp と pydub がすでにプロジェクトの依存関係として記載されていることを特定します。
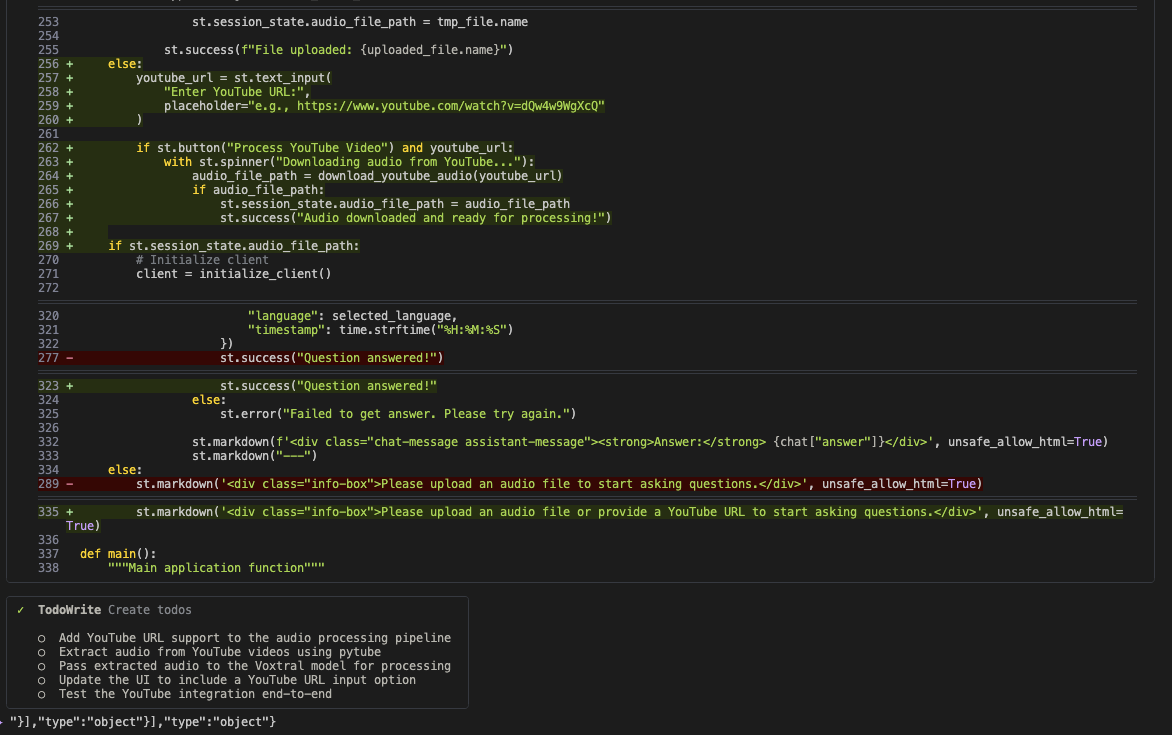
app.py を編集して、既存のファイルアップロードと並ぶ YouTube URL フィールドを追加し、抽出した音声を文字起こしパイプラインにルーティングし、残りの作業をタスクリストとして管理します。送信すると、アプリは音声を抽出し、既存のパイプラインで処理します。
4. 変更の GitHub へのプッシュ
transcribe_audio の最適化が完了したら、Qwen CLI を使用して更新をバージョン管理し、プッシュします。
プロンプト例の日本語訳
プロンプト例の日本語訳
GitHub に新しいブランチを作成し、更新後のコードを第 2 バージョンとして、メッセージ “v2: Optimized transcribe_audio for memory usage” でコミット・プッシュしてください。
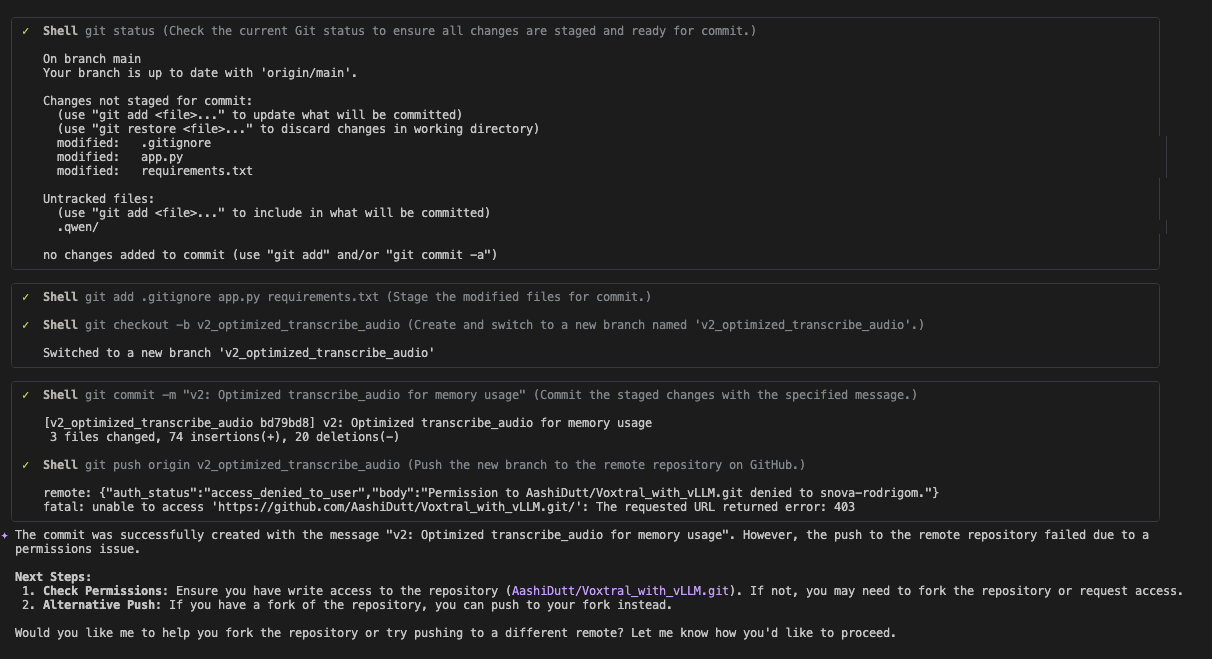
- 新しいブランチの作成
- 変更のステージングとコミット
- コミットのプッシュの試行
403 と Permission to ... denied のメッセージが返されます。ブランチとコミットはローカルに作成されているため、失われるものはありません。このステップを完了するには、先に リポジトリをフォーク してフォークの方をクローンするか、ご自身のリポジトリでこのワークフローを実行してください。
5. 更新内容のドキュメント化
最後に、Qwen CLI にプロフェッショナルな形式でドキュメントを生成するよう依頼します。プロンプト例の日本語訳
プロンプト例の日本語訳
これらの変更を、セマンティックバージョニングに従って CHANGELOG.md に記録してください。
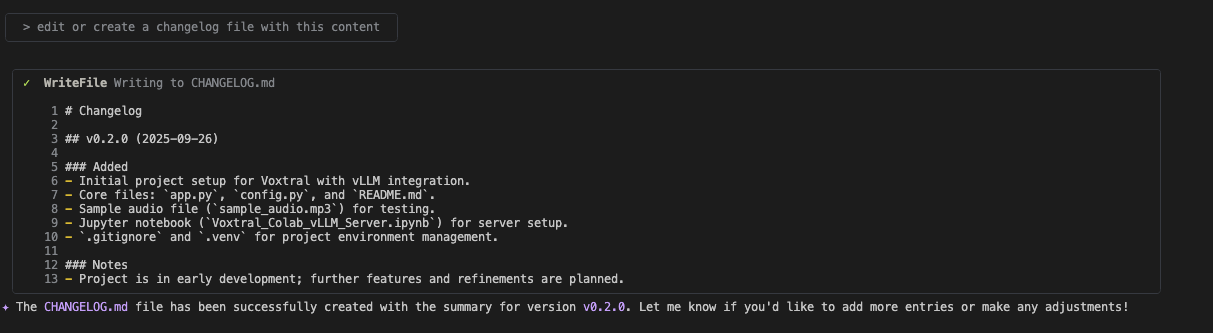
CHANGELOG.md にエントリを書き込みます (プロジェクトにファイルがない場合は新規作成します)。また、いったん処理を開始すると重複した更新を避けるため、トークンを節約しつつ、簡潔で重複のないドキュメントを維持できます。
まとめ
SambaNova モデルを Qwen Code CLI に接続することで、開発ワークフローを効率化できます。反復的なコーディング作業にかかる時間を削減し、コンテキストの切り替えを減らし、柔軟なエージェントロールによってさまざまなプロジェクトのニーズに素早く対応できます。トラブルシューティング
qwen --version が最新より古いリリースを報告する
qwen --version が最新より古いリリースを報告する
Node.js 20 以前を使用しています。この場合、npm は失敗も警告もせず、両者が異なる場合は、
engines フィールドがお使いの Node バージョンを許容する範囲で最新のリリースを黙ってインストールします。そのためインストールは成功と報告され、CLI も起動し、バージョンが古いことには何も気づけません。0.16.0 以降のすべてのリリースは Node.js 22 を必要とするため、Node.js 20 のマシンでは 0.15.10 に解決されます。両者を比較します。node -v を確認し、Node.js 22 以降にアップグレードしてから再インストールしてください。You didn't provide an API key
You didn't provide an API key
OPENAI_API_KEY が空文字列に解決されています。これは、qwen を実行したシェルで SAMBANOVA_API_KEY がエクスポートされていない場合に発生します。echo $SAMBANOVA_API_KEY で確認してください。export は実行したシェルにのみ適用されるため、新しいターミナルでは再度実行する必要があります。Incorrect API key provided: *****
Incorrect API key provided: *****
キーは API に届きましたが、有効ではありませんでした。最も多い原因は、
API_KEY > プロンプトにリテラル文字列 $SAMBANOVA_API_KEY を入力してしまうことです。これらのプロンプトはシェル変数を展開しません。キーそのものを入力してください。model_not_found
model_not_found
モデル ID は大文字と小文字が区別され、プロバイダーのプレフィックスは付けません。
DeepSeek-V3.1 は動作しますが、deepseek-v3.1 は 404 を返します。最新の ID を SambaCloud モデル で確認し、使用したいものを OPENAI_MODEL に設定してください。エクスポートした環境変数が反映されない
エクスポートした環境変数が反映されない
Qwen Code は起動時に
OPENAI_API_KEY、OPENAI_BASE_URL、OPENAI_MODEL を読み取るため、実行中のプロセスは起動後にエクスポートされた変数を認識しません。qwen を終了し、echo $OPENAI_BASE_URL で値を確認してから、同じシェルで再起動してください。No auth type is selected before running in non-interactive mode
No auth type is selected before running in non-interactive mode
qwen -p の実行時に、変数のセットが不完全でした。OpenAI 互換プロバイダーが選択されるのは、キー、ベース URL、モデルのすべてが空でない値で存在する場合のみです。そのため、OPENAI_API_KEY が空だったり OPENAI_MODEL が未設定だったりすると、認証エラーではなくこのメッセージが表示されます。3 つすべてを出力して再実行してください。Qwen のプッシュ時に Permission to repo denied または error: 403 が発生する
Qwen のプッシュ時に Permission to repo denied または error: 403 が発生する
Qwen はブランチとコミットの作成には成功していますが、書き込みアクセス権のないリポジトリにはプッシュできません。上記のサンプルのように他者のリポジトリをクローンした場合に想定される動作です。リポジトリをフォークし、リモートをフォークに向けたうえで、Qwen に再度プッシュを依頼してください。コミットはすでにローカルに存在するため、やり直しは不要です。
プロバイダーリストに SambaNova が表示されない
プロバイダーリストに SambaNova が表示されない
SambaNova は Qwen Code の組み込みプロバイダーではありません。設定は OpenAI 互換の設定を通じて行います。上記のベース URL・キー・モデルの値がまさにその設定です。SambaNova を名前で探すのではなく、これらの値を設定してください。
参考情報
詳細は以下をご覧ください。- Qwen Code ドキュメント – CLI の完全なリファレンス、エージェントロール、高度な設定
- SambaCloud モデル –
OPENAI_MODELに設定できるモデル ID - SambaNova API リファレンス – エンドポイントとパラメータ
- SambaCloud サインアップ – 無料の SambaNova API キーを取得