langchain-sambanova パッケージを通じて接続します。LangChain のチャットモデルには LangSmith 向けの計装があらかじめ組み込まれているため、ChatSambaNova はクライアントラッパーなしで単体でトレースされます。クライアントライブラリが介在しない LangSmith の UI では、SambaNova は OpenAI 互換エンドポイント経由で接続します。
本ガイドでは、SambaNova の呼び出しをトレースする手順と、SambaNova が評価対象のモデルとジャッジ (judge) の両方を務める評価を実行する手順を解説します。
前提条件
作業を始める前に、以下の環境を準備してください。- SambaCloud のアカウントと API キー。API キーと URL をご参照ください。
- LangSmith のアカウントと API キー。キーは LangSmith の Settings → API Keys で作成できます。LangSmith のキーは
lsv2_で始まります。 - Python 3.10 以上。
langchain-sambanovaのバージョン 1.x は Python 3.10 以上を必要とします。Python 3.9 では、pip は一致するディストリビューションが見つからないと報告します。
セットアップ
1
必要なパッケージのインストール
バージョンの範囲指定は残してください。リリース 1.0.0 では
ChatSambaNovaCloud
クラスと ChatSambaStudio クラスが削除されており、このパッケージは破壊的変更を
含むメジャーリリースを実際に出しています。pydantic は langchain-core の
依存関係として自動的にインストールされますが、評価のサンプルコードでは直接
インポートしているため、明示的にインストールしてください。2
環境変数の設定
LANGSMITH_TRACING は必ず true に設定してください。設定されていない場合、
SDK はコードを通常どおり実行するものの LangSmith には何も送信しないため、
プロジェクトは空のままになり、エラーも発生しません。ChatSambaNova は SAMBANOVA_API_KEY を自動的に読み取り、デフォルトで
https://api.sambanova.ai/v1 に接続するため、ベース URL の設定は不要です。
SambaStack ユーザーは、これに加えて SAMBANOVA_API_BASE にデプロイメントの
URL を設定するか、ChatSambaNova に base_url を渡します。SambaNova 呼び出しのトレース
ChatSambaNova は LangChain のチャットモデルであるため、LangSmith が自動的に計装します。クライアントラッパーは不要です。自作の関数に @traceable デコレータを付けると、モデル呼び出しを名前付きの親の Run の下にまとめられます。
sambanova-demo を選択します。LangSmith は最初のトレースの時点でプロジェクトを作成するため、手動で追加しなくても表示されます。2 件の Run が確認できます。
プロジェクトが空の場合は、LangSmith プロジェクトは作成されるが Run が記録されない をご参照ください。
SambaCloud が現在提供している任意のモデル ID を指定できます。モデルカタログは
随時変更されるため、SambaCloud モデル で ID を
確認するか、
curl https://api.sambanova.ai/v1/models で直接一覧を取得してください。
モデルを評価のジャッジとして使う場合は、Function calling にも対応している必要が
あります。Function calling をご参照ください。汎用の OpenAI クライアントを前提としたガイドでは、クライアントを
wrap_openai で
ラップしています。この手順はここでは不要です。ラップは、LangSmith と連携していない
SDK に Run ツリーを持たせるための仕組みであり、LangChain のモデルは最初から
Run ツリーを出力します。また、ChatSambaNova を使用すると、子の Run には汎用の
ChatOpenAI ではなく ChatSambaNova というラベルが付くため、トレース表示の中で
SambaNova の呼び出しを識別しやすくなります。評価の実行
Client.evaluate は、データセットに対してターゲット関数を実行し、指定した Evaluator (評価器) で各結果を採点します。以下の例では両方の役割に MiniMax-M3 を使用し、ツール呼び出しを強制する形で正確性を採点します。これにより、ジャッジは散文ではなく構造化された判定を返します。
correctness スコアが、その reasoning (判定理由) のコメントとともに表示され、列ヘッダーには実験全体の平均が表示されます。初回の実行が正常であれば、エラーなしで 3 問中 3 問が正解としてスコアリングされます。
各行では
target 用とジャッジ用の 2 回のモデル呼び出しが発生するため、この 3 行の
データセットでは 1 回の実行につき 6 回の呼び出しが発生します。max_concurrency=2
は同時に実行される数の上限です。大きなデータセットを速く処理するには値を上げられ
ますが、ターゲットとジャッジは同じクォータを消費するため、先に
レート制限 をご確認ください。ジャッジの信頼性を支えているのは
tool_choice="required" です。この指定により、
コード側でのパースが必要になる散文の判定ではなく、構造化されたツール呼び出しの
出力をモデルに強制します。bind_tools は Grade モデルから JSON Schema を導出する
ため、採点方法をモデルに伝えるのは docstring と各 Field の description です。
判定は result.tool_calls[0]["args"] から読み取ります。LangChain が既に dict に
パースしているため、json.loads は不要です。MiniMax-M3 は Function calling に
対応しています。対応モデルの一覧は
Function calling をご参照のうえ、選んだモデルを
ジャッジとして使う前に、そのページに掲載されていることを確認してください。Playground での SambaNova の利用
Playground を使うと、コードを書かずに SambaNova に対してプロンプトをテストできます。Playground と後述のマネージド Evaluator は、LangSmith の UI 上の機能です。モデルの
呼び出しは LangSmith 自身のサーバーから行われるため、クライアントライブラリは
介在せず、
langchain-sambanova は使用されません。代わりに、以下に示すとおり
OpenAI Compatible Endpoint プロバイダーで接続します。前述の Python の
セクションでは ChatSambaNova を使用しています。1
ワークスペースシークレットへの API キーの保存
Settings → Provider secrets に移動します。Workspace Secrets の下で
Secret を選択し、キーとして 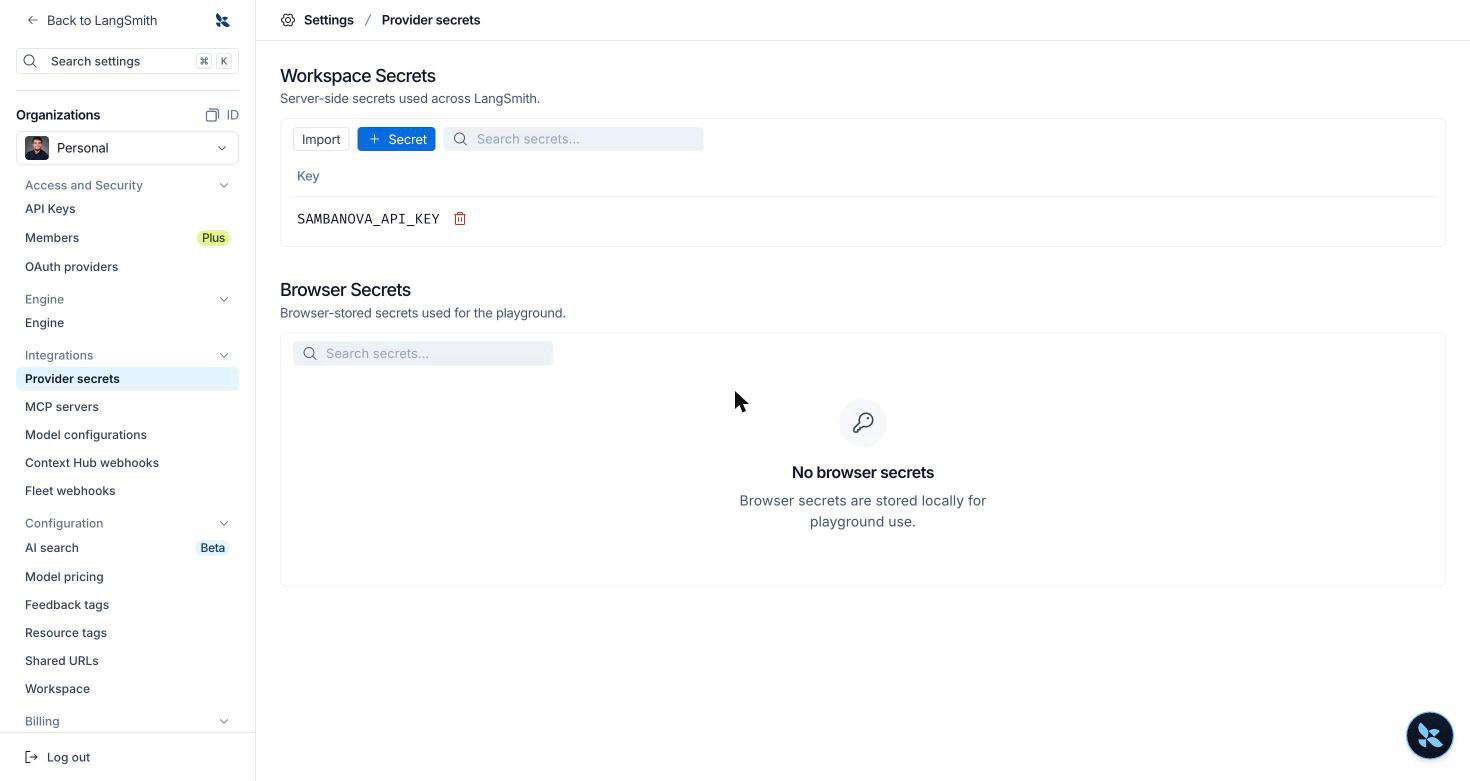
SAMBANOVA_API_KEY を追加して、値として
SambaCloud の API キーを貼り付けます。2
モデルの設定
Playground を開き、プロンプトツールバーのモデル名を選択して
Model Configuration を開き、以下を設定します。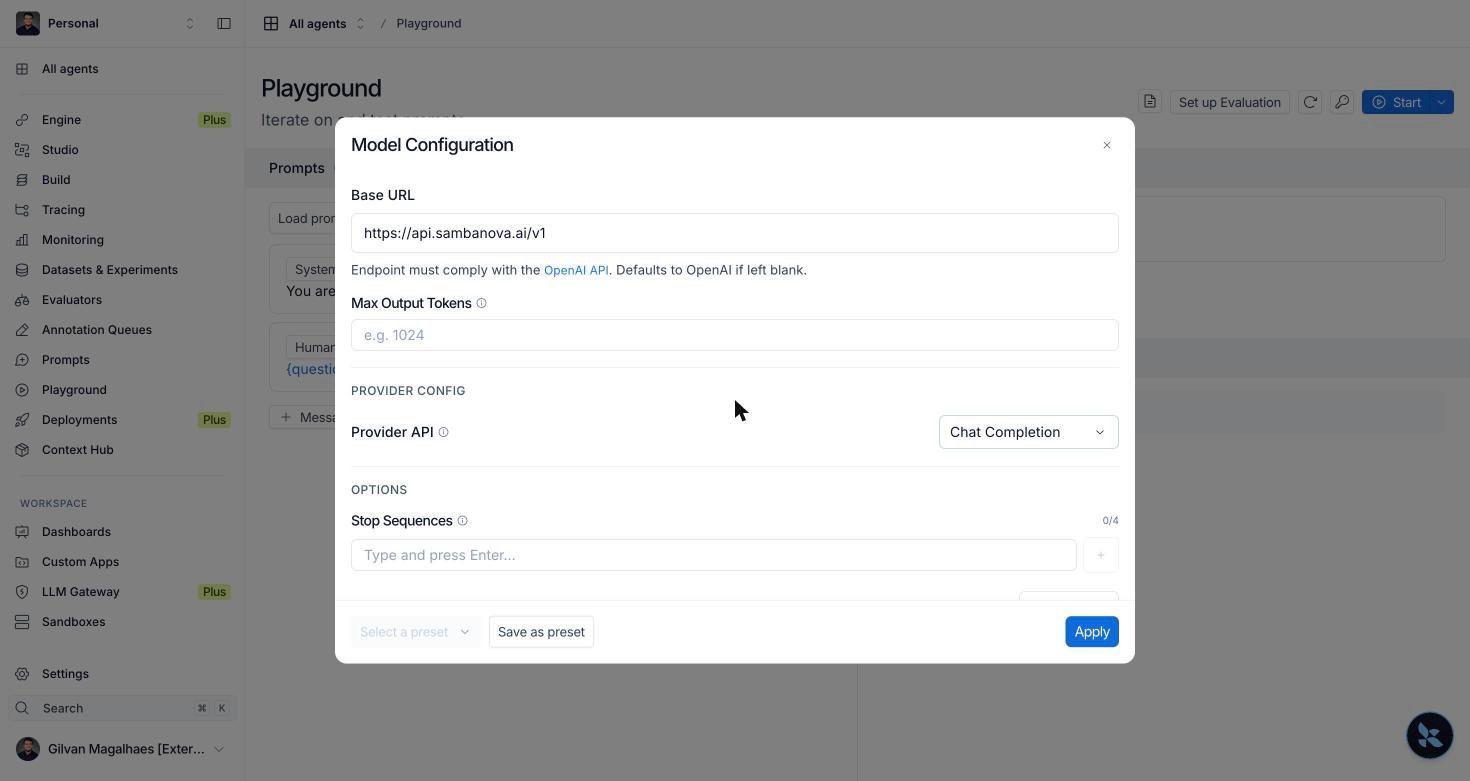
Base URL には
https://api.sambanova.ai/v1 を入力します。/chat/completions は
LangSmith が自動的に付加するため、これを含めるとリクエストパスが不正になります。
使用したいモデルがドロップダウンにない場合は、モデル ID を直接入力して選択して
ください。Provider Name は任意で、モデル料金の参照に使用されます。3
プロンプトの実行
Apply を選択し、プロンプト変数に値を入力してから Start を選択します。
応答が Output ペインにストリーミング表示され、Run は自動的にトレースされます。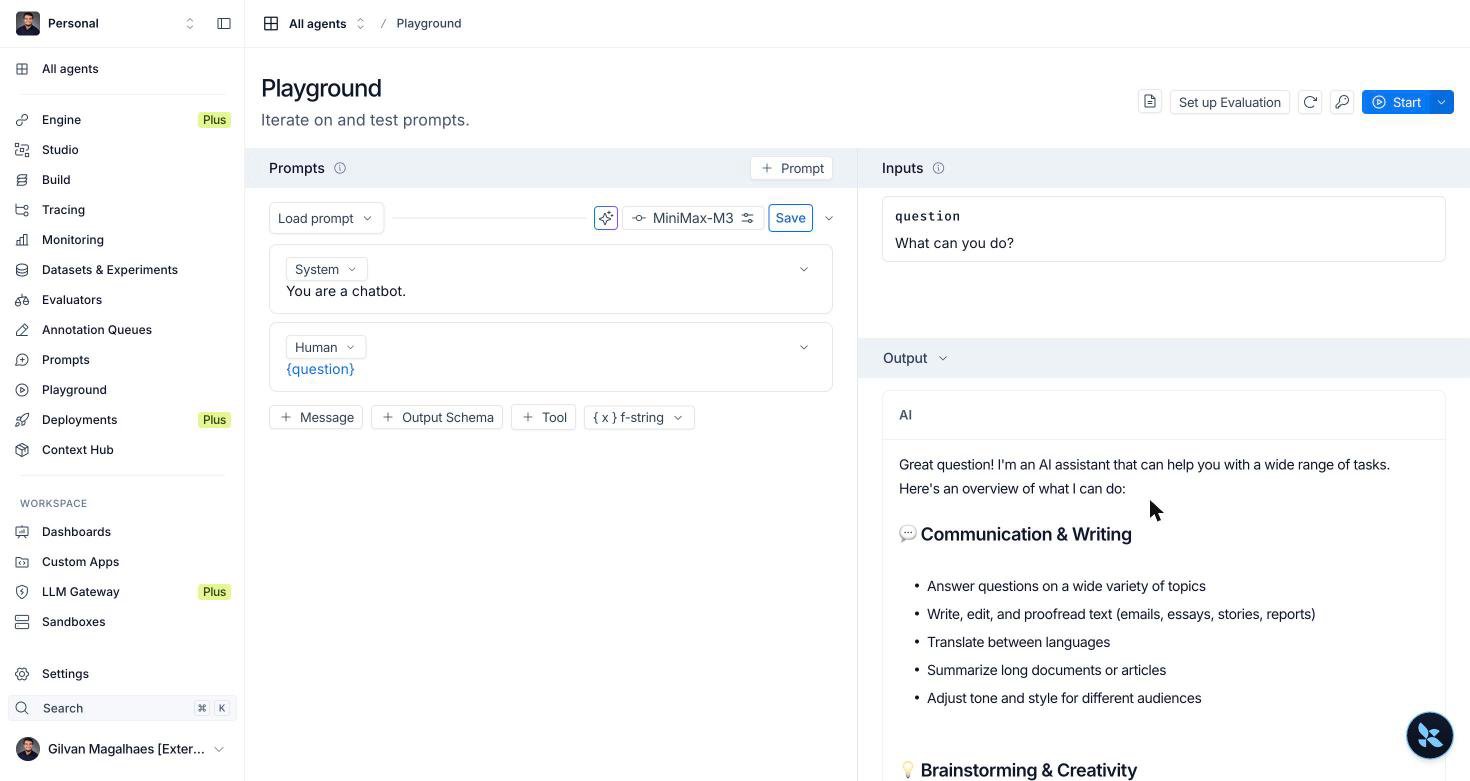
マネージド Evaluator による Run のスコアリング
LangSmith では、プロジェクト側に Evaluator のコードを置かずに、LLM-as-judge 方式の Evaluator をサーバーサイドで実行することもできます。この場合もジャッジ自体は SambaNova 上で動作します。1
Evaluator の作成
Evaluators に移動し、Evaluator を選択します。Configure Evaluator
パネルで、Create from scratch の下にある LLM-as-a-Judge Evaluator を
選択し、名前を付けます。パネルには PII Leakage や Toxicity などの事前構築済み
テンプレートも用意されていますが、ここでは使用しません。Feedback Configuration の下で、フィードバックキー、評価基準の説明、
Boolean などの応答形式を設定します。
2
ジャッジを SambaNova に接続
モデル名を選択して Model Configuration を開き、Playground と同じ設定を
適用します。プロバイダーは
OpenAI Compatible Endpoint、モデルは MiniMax-M3、
API キー名は SAMBANOVA_API_KEY、ベース URL は https://api.sambanova.ai/v1、
Provider API は Chat Completion です。Apply を選択し、続けて Save を
選択します。3
データセットへの紐付け
データセットを開き、Evaluator を選択して、保存した Evaluator を選び、
Save を選択します。以降、そのデータセットに対する新しい実験はすべて自動的に
スコアリングされます。
4
実験の実行とスコアの確認
そのデータセットに対して任意の実験を実行します。Evaluator のフィードバックキーが
スコア列として表示され、行ごとの値と実験全体の平均を確認できます。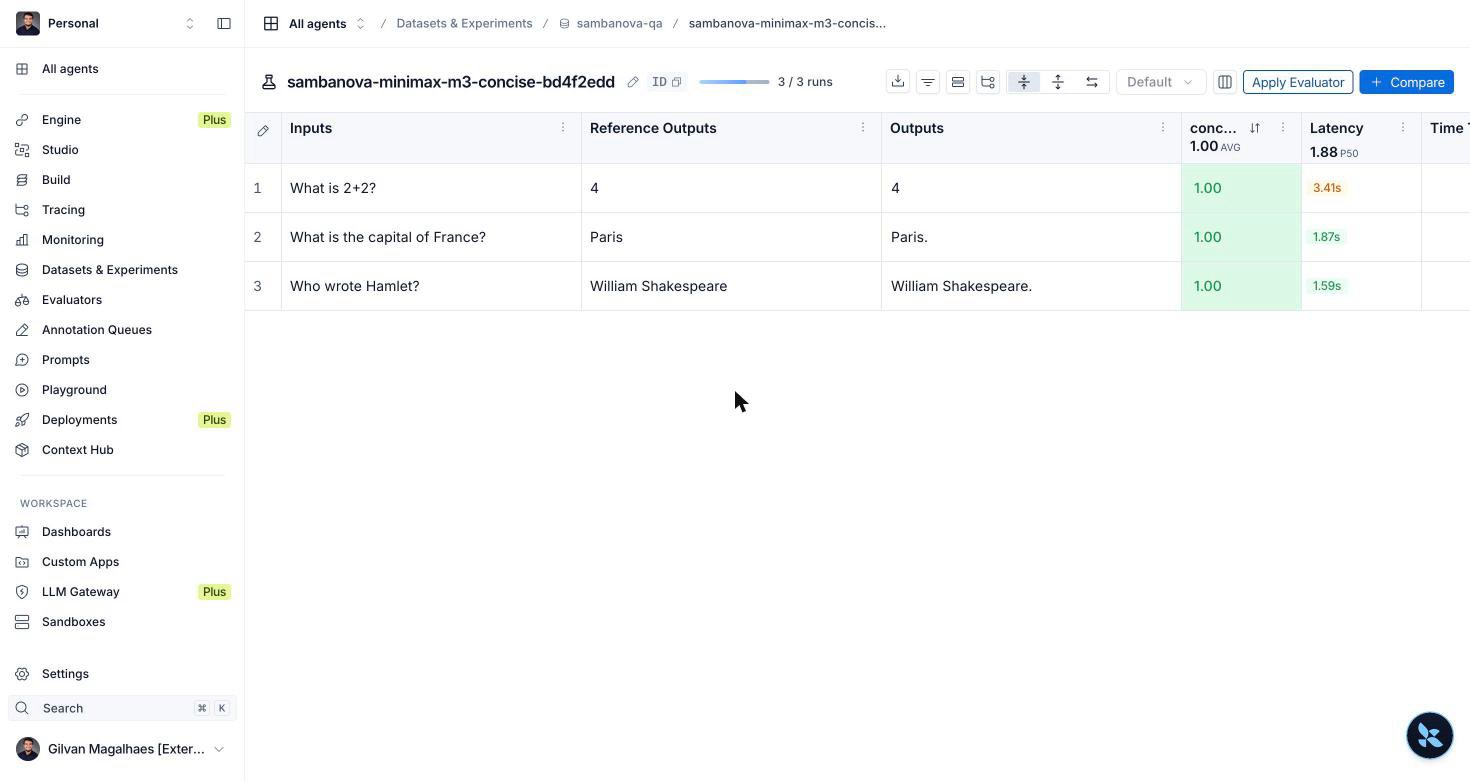
マネージド Evaluator は
evaluate 呼び出しの一部ではありません。実験の完了後に
非同期で実行されるため、スコアは即時ではなく 1〜2 分後に表示されます。スコアを
その場で受け取る必要がある場合は、自分のコード内で Evaluator 関数を使用してください。トラブルシューティング
pip が langchain-sambanova を見つけられない
pip が langchain-sambanova を見つけられない
バージョン 1.x は Python 3.10 以上を必要とします。Python 3.9 では、pip は
バージョンが原因であるとは示さず、
No matching distribution found for langchain-sambanova と報告します。
python -V でインタープリターを確認し、3.10 以上の環境にインストールしてください。LangSmith プロジェクトは作成されるが Run が記録されない
LangSmith プロジェクトは作成されるが Run が記録されない
LANGSMITH_TRACINGがtrueに設定されていることを確認してください。未設定の場合、トレーシングはエラーを出さずに無効化されます。- トレースの送信はバックグラウンドで行われます。短いスクリプトはアップロードの完了前に終了することがあるため、数秒待ってからプロジェクトを再読み込みしてください。
SambaNova からの認証エラー
SambaNova からの認証エラー
- キーがエクスポートされていることを確認します:
echo "${SAMBANOVA_API_KEY:0:10}..." - 無効なキーは、HTTP 401 と
"code": "invalid_api_key"を返します。SambaCloud ポータル でキーを再生成してください。 ChatSambaNovaはデフォルトでhttps://api.sambanova.ai/v1に接続するため、ベース URL の設定は不要です。SambaStack を使用している場合は、SAMBANOVA_API_BASEがデプロイメントの URL を指していることを確認してください。
RateLimitError: Error code: 429 rate limit exceeded
RateLimitError: Error code: 429 rate limit exceeded
ティアで許可されているリクエスト数を超過しました。各行がターゲット用とジャッジ用の
2 回の呼び出しを発行し、
max_concurrency がそれを掛け合わせるため、最も発生し
やすいのは評価の実行中です。max_concurrencyを下げるか、間隔を空けて再試行してください。- 適用される制限は レート制限 をご参照ください。
content が空になる
content が空になる
MiniMax-M3 は Reasoning モデルです。reasoning は別の reasoning フィールドで
返し、最終的な回答を content で返します。max_tokens が小さすぎると、回答の
トークンが生成される前の reasoning の途中で生成が打ち切られるため、content は
空 ("") になり、finish_reason は length になります。finish_reasonを確認してください。値がlengthの場合は上限に達したことを意味し、モデルの回答が悪かったわけではありません。max_tokensを増やしてください。テストでは、本ガイドのデータセットのような短い事実質問は合計 (reasoning と回答) で 100 トークンを大きく下回りましたが、より長く複雑なプロンプトに備えて余裕を持たせてください。- これが特に重要なのは評価のターゲットです。空の回答が、モデルの実際の応答として採点されるためです。
マネージド Evaluator のスコアが表示されない
マネージド Evaluator のスコアが表示されない
- マネージド Evaluator は、実験の完了後にスケジュールに従って実行されます。1〜2 分待ってから実験を再読み込みしてください。
- Evaluator がデータセット自体に紐付いていることを確認してください。Evaluators 配下で Evaluator を保存しただけでは、どこにも紐付きません。
- Provider API が
Chat Completionになっていることを確認してください。これは Playground と同じ要件です。
LangSmith の UI で Base URL が拒否される
LangSmith の UI で Base URL が拒否される
これは Playground とマネージド Evaluator に該当し、
ChatSambaNova には該当
しません。LangSmith は、入力されたベース URL に /chat/completions を付加します。
https://api.sambanova.ai/v1 を入力し、末尾に /chat/completions を含めないで
ください。