

SambaStack での DeepSeek-V3.2 の思考モード (thinking mode) をお探しですか?この機能はオプションで、デフォルトでは無効になっています。詳細は DeepSeek-V3.2 の思考モード をご参照ください。
モデル情報
DeepSeek-R1 は、6,710億パラメータを持つオープンソースの Reasoning モデルです。ユーザープロンプトにどのように応答するべきかを熟考するための専用トークンを使用しており、これらは出力内の<think> タグの中に表示されます。通常のモデルリクエストとは構造が異なるため、以下のような調整を検討してください。
システムプロンプト
- 指示的なシステムプロンプトは削除し、ユーザークエリ以外の追加プロンプトは最小限にしてください。過度な指示はモデルの思考範囲を制限し、出力品質を低下させる可能性があります。
ユーザープロンプト
- モデルはクエリを自身の思考アプローチで処理するため、追加の CoT プロンプティングや応答方法の明示は避けてください。複雑なタスクには、ゼロショットまたは単一の指示によるシンプルな自然文のプロンプトを使用するのが最適です。このアプローチにより、モデルが本来備えている内部の reasoning 能力を最大限に引き出せます。
- 目的 (goal)、出力形式 (return format)、注意事項 (warnings)、文脈情報 (context dump) といったセクションの構成は、試行錯誤しながら調整してください。
- まれに
<think>タグが省略されることがありますが、その場合は<think>タグから出力を開始するようモデルに指示することで、使用を強制できます。 - 思考を簡潔にするには、Chain-of-Draft の考え方が活用できます。たとえば、「各思考ステップのドラフトは最小限に保ち、最大 5 単語までとする (“only keep a minimum draft for each thinking step, with 5 words at most”)」といった制約をプロンプトに追加します。

パラメータ
- 一般的な (数学以外の) reasoning タスクには、
temperature= 0.6、top-p= 0.95 を推奨します。より事実に基づいた応答を得たい場合は、temperatureを 0.5 など、より小さい値に設定できます。 - 数学系の reasoning タスクには、
temperature= 0.7、top-p= 1.0 を推奨します。
リクエスト例
ユースケース
レポート生成
DeepSeek-R1 は非構造化情報の処理に特に優れており、法律文書、財務諸表、学術論文などの複雑なドキュメントの分析に適しています。Reasoning モデルは、情報を多角的に分析した上で包括的な要約へと集約することで、パターン認識を支援します。 プロンプト例Develop a comprehensive report on the state of autonomous vehicles. Present this report with organized sections and a brief summarization. Be careful to cite the achievements with the proper entity that made that achievement or contribution. For context: I am knowledgeable in this field and have a technical understanding of autonomous vehicle systems. I've been working most of my career in artificial intelligence but have not yet joined a company with the sole focus of autonomous vehicles. I am considering making the career change and wanted to understand the current ecosystem before I go through the job search process.
プロンプト例の日本語訳
プロンプト例の日本語訳
自動運転車の現状について包括的なレポートを作成してください。各セクションごとに内容を整理し、簡潔な要約を示してください。実績を引用する際は、その実績や貢献を行った適切な組織名を明記してください。前提として、私はこの分野に詳しく、自動運転システムの技術にも精通しています。これまで AI 分野でキャリアを積んできましたが、自動運転に特化した企業にはまだ所属したことはありません。キャリアチェンジを検討しており、転職活動を始める前に現状のエコシステムを理解したいと考えています。
ワークフローやエージェントのプランナー
Reasoning モデルは、曖昧で複雑なタスクへの対応に優れています。複雑な問題を分解し、解決策を戦略立てて考え、大量の曖昧な情報に基づいて意思決定を行うことができます。DeepSeek-R1 は、複雑な多段階の問題に対する戦略的プランナーとして活用してください。タスクの分解や詳細な解決策の立案に加え、エージェントシステム内の特定のサブタスクに対して、他の AI モデルをオーケストレーションすることもできます。 強力なワークフローにおける熟慮された計画立案の幅広い能力を体感できるように、デモアプリ では DeepSeek-R1 をプランナーとして実装しています。このアプリは、Deep Research、Financial Analysis、Sales Leads など、さまざまなワークフローを担うエージェントをオーケストレーションします。オープンソースとして公開されているため、開発者はこのシステム内で独自のエージェントワークフローを素早く実験し、容易に構築できます。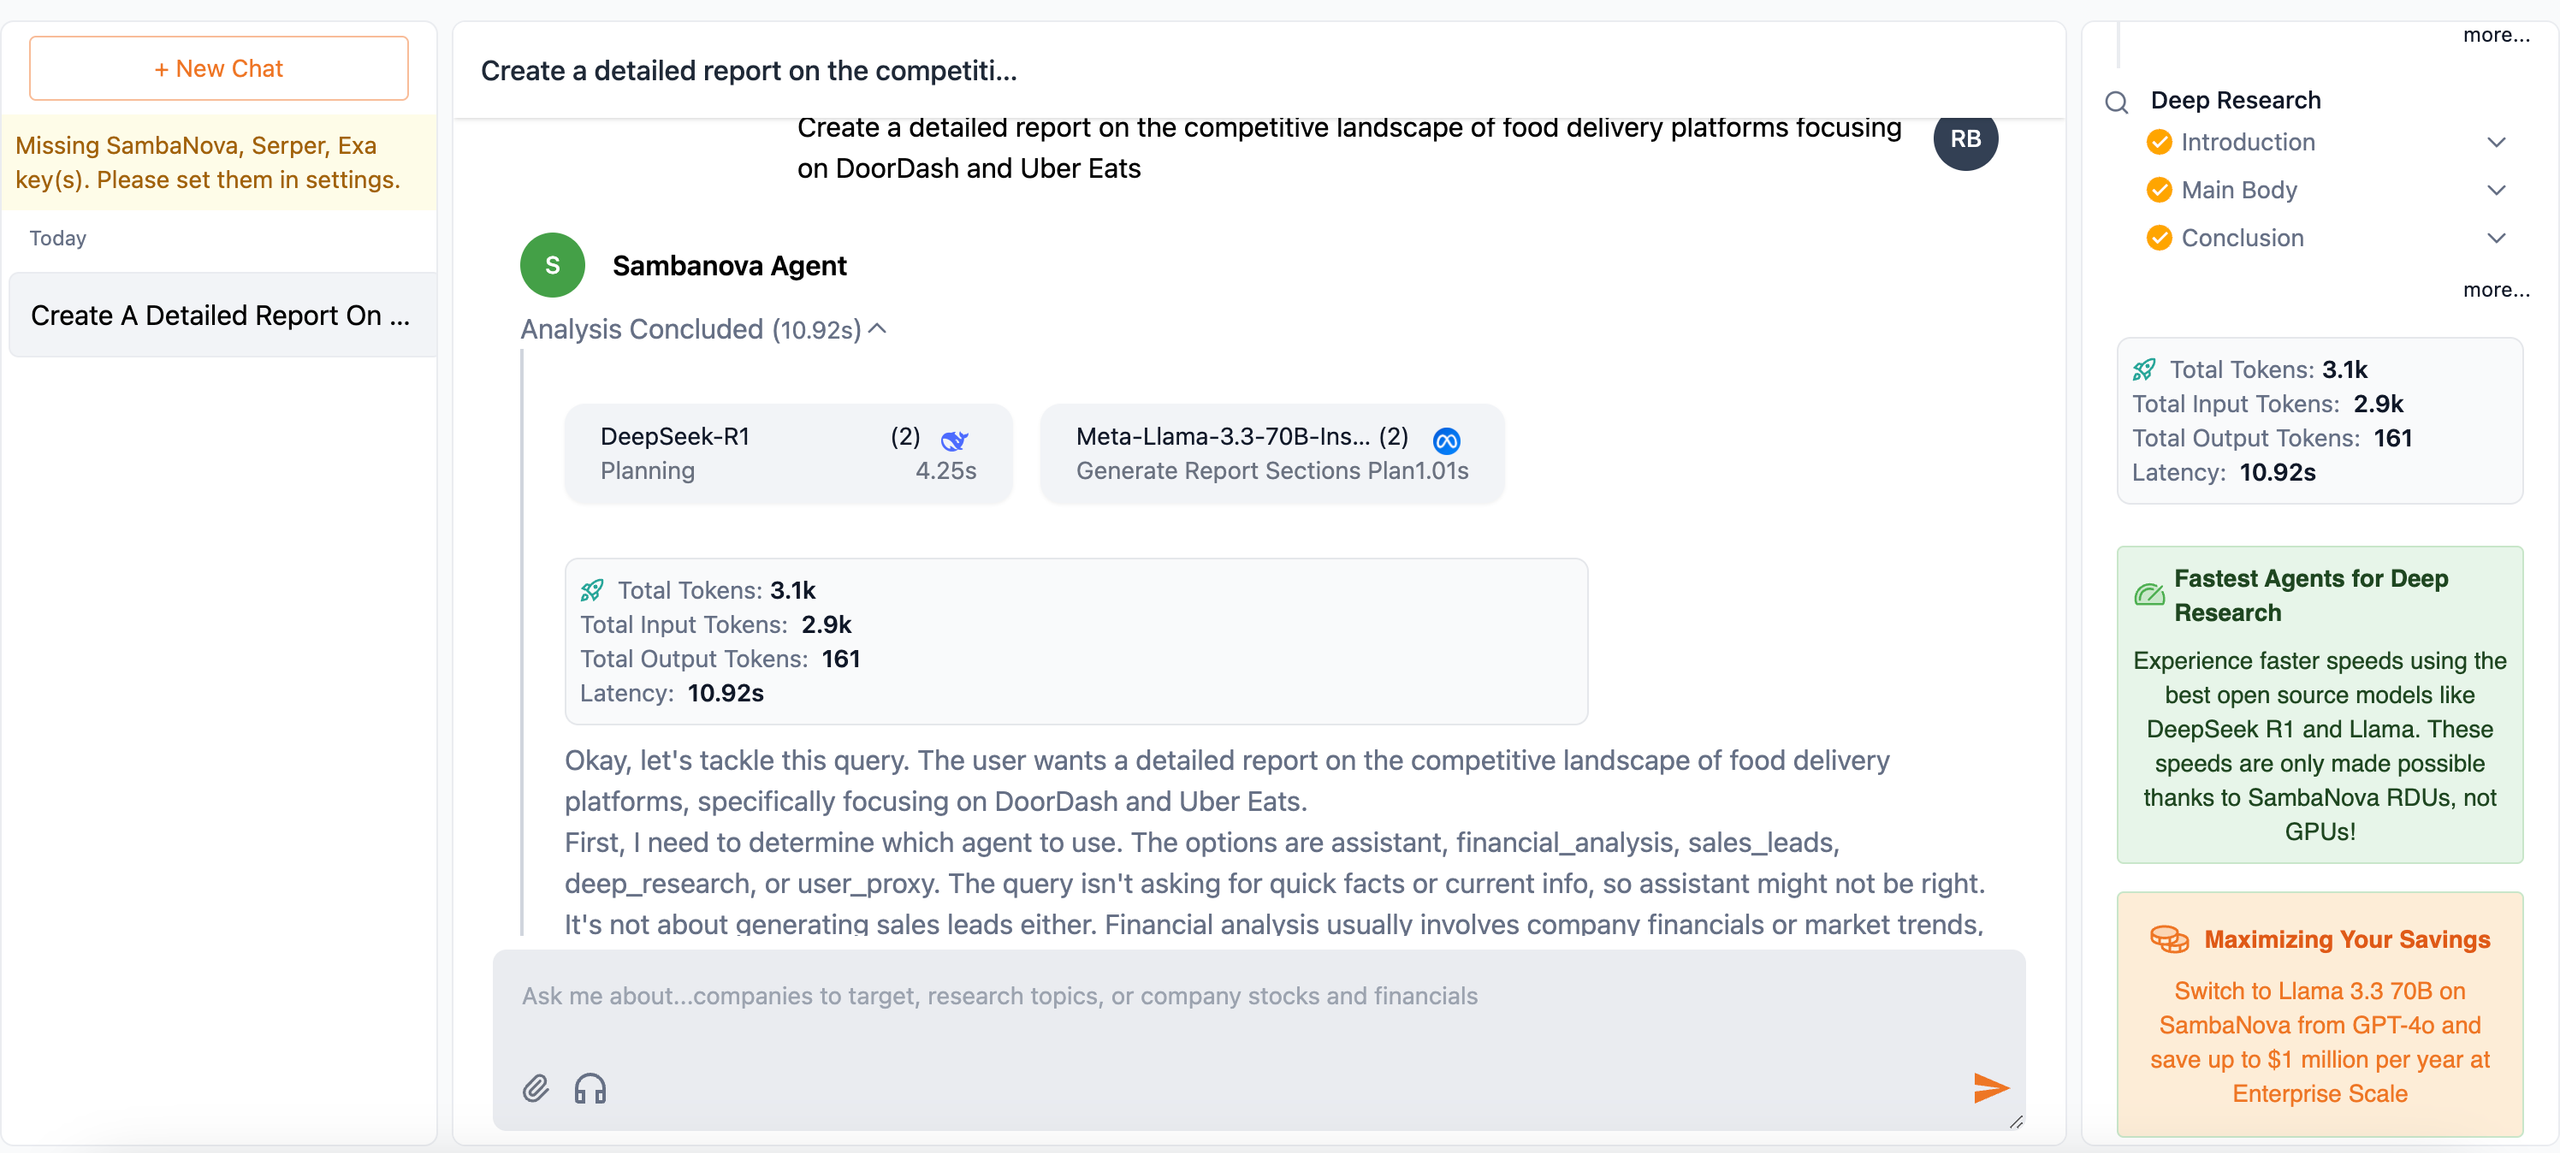
コーディングと数学のエキスパート
これらのモデルは、コードのレビューと改善に効果的です。人間のレビュアーが見落としがちなコードベースの細かな変更も検出できます。数学の問題を解く際にも、タスクを多くのステップに分解し、解答の過程全体を通じて検証を行う上で、reasoning が役立ちます。ベストプラクティス
レイテンシと費用
レイテンシと費用
Reasoning モデルの出力は、
<think> プロセスを伴うため、レイテンシとトークン使用量が大きくなります。予算や応答時間の要件を最適化するために、単純なタスクには非 Reasoning モデルの使用を検討してください。プロンプトをより包括的に考慮できるという利点がある一方で、完全な回答の生成には多くのトークンと時間を要します。より深い reasoning のアプローチが価値をもたらす場面で、このモデルを活用してください。ストリーミング
ストリーミング
DeepSeek-R1 を使用するアプリケーションでは、ストリーミングを有効にすることでユーザー体験を向上させることができます。生成プロセスが長くなるため、トークンを利用可能になり次第表示することで、待ち時間の不確かさや心理的負担を軽減できます。モデルリクエストにパラメータ
stream=True を追加することで実装できます。Function calling
Function calling
DeepSeek のドキュメント (英語) でも指摘されているとおり、DeepSeek-R1 における現在の Function calling の実装は不安定であり、ループした呼び出しや空の応答が発生することがあります。プロンプトエンジニアリングによる試行錯誤で回避することも可能ですが、別のモデルを使用するのが最適です。Llama-3.3-70B などのモデルによる Function calling の詳細は、Function calling と JSON モード のページをご覧ください。
よくある質問
DeepSeek-R1 の最大コンテキスト長に関する「BadRequestError: 400」が発生しました。この情報はどこで確認できますか?
DeepSeek-R1 の最大コンテキスト長に関する「BadRequestError: 400」が発生しました。この情報はどこで確認できますか?
モデルの現在のコンテキスト長については、SambaCloud モデル のページをご確認ください。また、エラーに関するご質問は、SambaNova コミュニティ までお気軽にお寄せください。
このモデルは中国企業が開発したものですが、どこでホスティングされていますか?
このモデルは中国企業が開発したものですが、どこでホスティングされていますか?
SambaNova は、主に米国内のデータセンターでモデルをホスティングしており、一部は日本国内のデータセンターでも稼働しています。
どうすれば利用できますか?
どうすれば利用できますか?
まずは Playground でモデルをお試しください。その後、API キー を取得すると、利用可能になり次第アクセスできます。